Secondo alcuni sondaggi come quello di JetBrains, la versione 8 di Java è al momento quella più utilizzata in assoluto dagli sviluppatori di tutto il mondo, nonostante si tratti di una release del 2014.
Quello che state leggendo è un articolo che fa parte di una serie di articoli intitolata "Superare Java 8", ispirata ai contenuti del mio ultimo libro "Il nuovo Java". Questi articoli accompagneranno passo dopo passo il lettore all'esplorazione delle più importanti caratteristiche introdotte a partire dalla versione 9. L'obiettivo è quello di far acquisire la consapevolezza di quanto è importante aggiornare le proprie conoscenze relative a Java, spiegando gli enormi vantaggi che offrono le ultime versioni del linguaggio.
String è indubbiamente la classe più utilizzata in Java, e rappresenta una
eccezione tra le classi della libreria standard. Ricordiamo infatti che i suoi oggetti
sono sempre immutabili, che questi possono essere istanziati con una sintassi
semplificata che ci fa evitare la verbosità dell'operatore new e della
chiamata al costruttore come è standard per quasi tutte le altre classi. Inoltre la
gestione della memoria di questi oggetti String, è caratterizzata dal riuso
delle istanze già create mediante un'apposita pool di stringhe. Nelle ultime versioni si
stanno apportando altri miglioramenti a questa fondamentale classe per rendere il suo
utilizzo più performante, più semplice e meno verboso. Le
compact strings introdotte in
Java 9, hanno reso le stringhe indubbiamente più performanti. Con Java 13 invece, è stata
introdotta una nuova caratteristica chiamata text block, che permette di utilizzare la classe
String in maniera più proficua e più semplice. Tale caratteristica permette
alle stringhe di essere definite su più linee utilizzando una nuova sintassi. La
formattazione delle stringhe multilinea è più naturale rispetto al passato: non sarà più
necessario ricorrere continuamente a concatenazioni di stringhe, a caratteri di escape
come \n, e ad una complessa gestione delle virgolette e delle spaziature.
In questo modo la verbosità del codice diminuisce, ed è favorita la leggibilità e la
facilità di scrittura. In Java 13 e Java 14, i text block potevano essere utilizzati
come feature preview. A partire da Java 15 sono diventati
a tutti gli effetti una caratteristica standard del linguaggio.
A cosa servono
Essendo Java un linguaggio che normalmente si interfaccia con altri linguaggi e
tecnologie, capita spesso di dover formattare all'interno di stringhe, istruzioni
scritte in altri linguaggi come SQL, JPQL, XML, JavaScript, JSON, HTML etc. Come
sappiamo la formattazione è fondamentale per comprendere le istruzioni di tali
linguaggi.
Per esempio, supponiamo di voler utilizzare il seguente codice HTML, in un programma
Java:
<HTML>
  <BODY>
    <H1>Hello World!</H1>
  </BODY>
</HTML>
Prima di Java 13, per formattare del codice HTML come questo all'interno di una stringa,
eravamo obbligati ad utilizzare caratteri di escape come \n per andare da capo:
String html = "<HTML>\n <BODY>\n <H1>Hello World!</H1>\n </BODY>\n</HTML>";
Per rendere il tutto leggibile avevamo anche bisogno di concatenare più stringhe con
l'operatore +:
String htmlFile = "<HTML>\n" +
                  "  <BODY>\n" +
                  "    <H1>Hello World!</H1>\n" +
                  "  </BODY>\n" +
                  "</HTML>"
Formattazioni come la precedente, nonostante l'aiuto di un IDE, richiedono una certa attenzione da parte del programmatore. Per esempio, se nel codice HTML precedente ci fosse un attributo che usa il simbolo di virgolette:
<H1 style="color: blue;">Hello World!</H1>
allora dovremmo andare ad utilizzare i caratteri di escape (vedi articolo
Stranger things sul
tipo Java
char) per non creare problemi di sintassi al nostro codice, nel
seguente modo:
String htmlFile = "<HTML>\n" +
                  "  <BODY>\n" +
                  "    <H1 style=\"color: blue;\">Hello World!</H1>\n" +
                  "  </BODY>\n" +
                  "</HTML>"
Dalla versione 13 possiamo invece utilizzare equivalentemente un text block, che è simile ad un normale
String literal, ma si espande su più righe ed è delimitato da sequenze di
tre virgolette:
String htmlFile = """
                  <HTML>
                    <BODY>
                      <H1 style="color: blue;">Hello World!</H1>
                    </BODY>
                  </HTML>""";
Possiamo notare come sia migliorata la leggibilità del codice HTML, e come ora sia più facile con un copia-incolla importare in un text block il codice da un file HTML, o copiare il contenuto di un text block in un file HTML. Inoltre non c'è bisogno di utilizzare caratteri di escape per le virgolette del codice HTML (approfondiremo più avanti). Ci sono però alcune precisazioni da fare, come vedremo a partire dalla prossima sezione.
Sintassi
Come abbiamo visto nell'esempio precedente, un text block è stato definito all'interno
di un delimitatore di apertura e un
delimitatore di chiusura, rappresentati da una
sequenza di tre virgolette """. In realtà, la situazione è un po' più
complessa, quindi facciamo chiarezza definendo in dettaglio le tre parti che compongono
un text block: il delimitatore di apertura, il contenuto del text block e il
delimitatore di chiusura.
Il delimitatore di apertura (in inglese opening delimiter) è definito da tre virgolette,
seguita da zero o più spazi ed un terminatore di linea (ovvero, l'andare da capo).
Il contenuto del text block parte dal primo carattere dopo la terminazione di linea.
Quindi, gli eventuali white space compresi tra le tre virgolette e la terminazione di
linea non sono presi in considerazione.
Character.
Il delimitatore di chiusura (in inglese closing delimiter) invece, è definito solo da tre
virgolette. Il contenuto del text block, termina con il carattere che precede la prima
virgoletta del delimitatore di chiusura.
Per quanto riguarda il contenuto del text block,
al runtime equivale ad aver definito uno String literal ordinario, non c'è
nessuna differenza. Una volta compilato, un text block diventa quindi uno
String literal a tutti gli effetti, ed al runtime viene immagazzinato nella
pool di stringhe come sempre. Non c'è nessuna possibilità che al runtime la JVM riesca
a distinguere gli string literal ordinari, da quelli che sono stati creati tramite un
text block. Ripetiamo che il contenuto del text block parte dal primo carattere dopo la
terminazione di linea, tuttavia bisogna tener presente quanto riportato nelle prossime
sezioni.
Compilazione di un text block
Per quanto riguarda invece la compilazione di un text block, esistono tre fasi che vengono eseguite:
- Normalizzazione dei terminatori di linea.
- Rimozione dei white space che sono stati introdotti per allineare il text block al codice Java.
- Interpretazione dei caratteri di escape.
\t, e dalla codifica Unicode (code point) \u0009 . Per supportare la
formattazione verticale invece, abbiamo bisogno dei caratteri per andare da capo, ovvero i
cosiddetti terminatori di linea (in inglese line terminators). Questi però, non vengono più
esplicitati con un carattere di escape \n come si fa solitamente in un normale
String literal, ma sono implicitamente definiti all'interno del codice sorgente
semplicemente andando da capo. Ma le piattaforme basate su Unix (per esempio i sistemi Linux
e MacOS), per andare da capo all'interno di un file di testo, utilizzano il carattere Line Feed (che abbreviamo con LF), e che può essere rappresentato in Java con il
carattere di escape \n, e con il code point \u000A. I sistemi
Windows invece, utilizzano come terminatori di linea la sequenza di caratteri Carriage Return e Line Feed. In particolare, il
Carriage Return (che abbreviamo con CR), può essere
rappresentato in Java con il carattere di escape \r, e con il code point
\u000D. Possiamo quindi dire che su Windows il terminatore di linea è
costituito dalla combinazione CRLF (ovvero
\u000D\u000A).
Normalizzazione dei terminatori di linea
La normalizzazione per i text block, trasforma
sempre e comunque tutti le terminazioni di linea in LF, indipendentemente dalla piattaforma
su cui viene eseguita. Questo processo è fondamentale perché nel trasferimento di un
file sorgente da una da una piattaforma ad un'altra, il numero di caratteri potrebbe
cambiare. Supponiamo di avere due file sorgenti Java che definiscono lo stesso text
block. Supponiamo anche che una delle due classi sia stata editata su un sistema Linux
(dove il terminatore di linea corrisponde a LF), e l'altra su un sistema Windows (dove
il terminatore di linea è CRLF). Un eventuale controllo tramite metodo
equals tra i due text block, restituirà false, anche se ad
occhio nudo sembrerebbero identici. Infatti, nel file editato su Windows esisterà un
carattere in più per ogni linea (\r).
Rimozione dei white space superflui
Dopo il processo di normalizzazione, il nostro text block sarà chiaramente composto da
una o più righe. L'algoritmo per rimuovere i white
space superflui, (ovvero gli spazi introdotti per allineare il codice del text
block con il codice Java) comprende:
- La rimozione di tutti i white space che sono in coda ad ogni riga.
- La rimozione di tutti i white space che sono all'inizio di ogni riga, comuni a tutte le righe.
public class TextBlockDemo {
    public static void main(String args[]) {
        String htmlFile = """
                          <HTML>
                            <BODY>
                              <H1>Hello World!</H1>
                            </BODY>
                          </HTML>  """;
        System.out.println(htmlFile);
    }
}
In questo caso, il codice HTML definito nel text box, è chiaramente stato definito con diversi white space iniziali per ogni riga, solo allo scopo di allineare il contenuto del text block (il codice HTML) con il suo delimitatore di apertura (vedi figura 1)
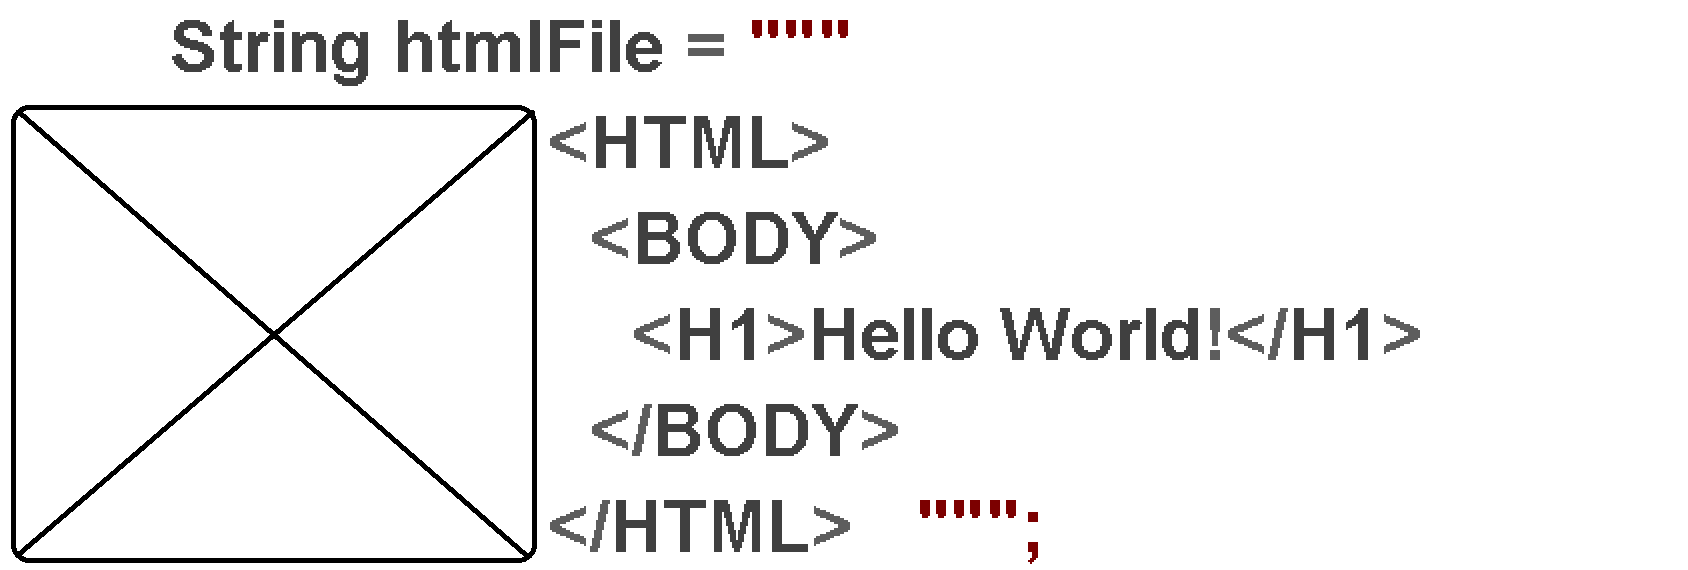
Figura 1 – I white space superflui sono evidenziati.
Per tale ragione tutti i white space che sono comuni ad ogni linea, verranno rimossi dal compilatore, e l'output della classe precedente sarà:
<HTML>
  <BODY>
    <H1>Hello World!</H1>
  </BODY>
</HTML>
e non:
                          <HTML>
                            <BODY>
                              <H1>Hello World!</H1>
                            </BODY>
                          </HTML>
Se il delimitatore di chiusura del text box si fosse trovato alla riga successiva, avremmo avuto un'ulteriore riga nell'output. Per esempio, il seguente text box:
String htmlFile = """
                  <HTML>
                    <BODY>
                      <H1>Hello World!</H1>
                    </BODY>
                  </HTML>
                  """;
sarebbe stato stampato con una riga finale vuota in più per causa del terminatore di linea che è stato spostato alla riga successiva:
<HTML>
  <BODY>
    <H1>Hello World!</H1>
  </BODY>
</HTML>
mentre il seguente text box:
        String htmlFile = """
                          <HTML>
                            <BODY>
                              <H1>Hello World!</H1>
                            </BODY>
                          </HTML>
""";
avrebbe prodotto il seguente output:
                          <HTML>
                            <BODY>
                              <H1>Hello World!</H1>
                            </BODY>
                          </HTML>
Infatti, l'ultima riga avrebbe avuto zero white space iniziali, e questo numero sarebbe stato considerato dal compilatore come il numero di white space da rimuovere per tutte le righe.
String introdotto con Java 13
stripIndent.
Interpretazione dei caratteri di escape
All'intero di text block, è possibile anche utilizzare i caratteri di escape (vedi
articolo Stranger Things sul tipo Java
char). Tecnicamente è possibile utilizzare anche i caratteri di escape
\n, e \", ma in realtà è inutile e quindi sconsigliato. Infatti,
\n serve per andare da capo all'interno degli String literal,
ma i text block sono multilinea di natura.
Possiamo utilizzare direttamente il carattere " invece del carattere di
escape \", visto che il delimitatore di un text block non è costituito da
un solo carattere ". In pratica non c'è possibilità di confondere i
caratteri " che appartengono alla stringa come delimitatori del text block
stesso.
", che quindi sarebbe agganciato al delimitatore di chiusura,
compromettendone la definizione. In questo caso è necessario usare il carattere di
escape.
Esistono comunque altri caratteri di escape che possono essere utilizzati.
È importante che l'interpretazione dei caratteri di escape, avvenga dopo le prime due
fasi di normalizzazione dei terminatori di linea, e di rimozione dei white space
superflui. Così infatti, i caratteri di escape come \n, \r e
\f non saranno rimossi durante la prima fase, mentre \b
("BACKSPACE") e \t ("TAB"), non saranno sicuramente rimossi nella seconda
fase.
Nuovi caratteri di escape
Con Java 14, sono stati introdotti due nuovi caratteri di escape. Il primo coincide con
il simbolo backslash \, e permette di ignorare i terminatori di linea che
seguono tale carattere sulla stessa riga. Infatti, se abbiamo una stringa troppo lunga
per la quale non si vuole andare da capo, di solito utilizziamo la concatenazione di
stringhe per migliorarne la leggibilità. Per esempio:
String lyrics1 = "The smile of dawn arrived early May, "
    + "she carried a gift from her home. "
    + "The night shed a tear to tell her of fear "
    + "and of sorrow and pain she'll never outgrow.";
ora possiamo riscrivere la stessa stringa con il seguente text block:
String lyrics2 = """
    The smile of dawn arrived early May, \
    she carried a gift from her home. \
    The night shed a tear to tell her of fear \
    and of sorrow and pain she'll never outgrow.""";
Il carattere \ si può utilizzare solo all'interno di text block, e non nei
literal delle stringhe.
L'altro carattere di escape introdotto con Java 14 è \s, e a differenza del
carattere di escape \, può ora essere utilizzato anche nei literal delle
stringhe. Esso equivale al carattere spazio (identificato con il code point
\u0020), ma usato all'interno di un text block, previene la rimozione dei
white space a fine riga che abbiamo descritto nella sezione "Rimozione dei white space
superflui". Per esempio, possiamo scrivere un text block, dove ogni riga sia sempre
costituita da 4 spazi. Nella figura 2, viene mostrato il dettaglio dell'esecuzione con
EJE (un editor per
sviluppare in Java creato da me) di un programma che usa tale text block, dove la
selezione dell'output evidenzia gli spazi che sono stati conservati a fine riga.

Figura 2 – La selezione mostra gli spazi a fine riga di un programma lanciato con
                                    EJE.
Concatenazione di text block
All'interno dei text block, è tecnicamente possibile concatenare i text block con altri
text block, String literal, variabili o chiamate a metodi. Praticamente, i
text block si possono usare in tutti i casi in cui si possono utilizzare gli
String literal. Con la concatenazione però la leggibilità potrebbe
peggiorare. Per esempio, consideriamo il seguente snippet che definisce e stampa un
text block che rappresenta una funzione JavaScript:
String functionName = "alert";
String jsFunction = "function dynamicFunction() {\n"+
                    "\t"+functionName+"(msg);\n" +
                    "}";
System.out.println(jsFunction);
L'output sarà:
function dynamicFunction() {
alert(msg);
}
ma la leggibilità del codice non è molto buona! Proviamo quindi ad utilizzare un text block per migliorare la situazione:
String functionName = "alert";
String jsFunction = """
                    function dynamicFunction() {
                    \t"""  + functionName + """
                    (msg);
                    }""";
System.out.println(jsFunction);
l'output sarà identico al precedente, ma la leggibilità è addirittura peggiorata! Infatti, ogni text block si espande almeno su due righe, vista la complessità della definizione del delimitatore di apertura.
Best Practice
In casi come questo, è preferibile utilizzare un unico text block su cui poter chiamare
il metodo replace della classe String, per esempio, come nel
seguente snippet:
String functionName = "$functionParameter";
String jsFunction = """
                    function dynamicFunction() {
                    \t$functionParameter(msg);
                    }""".replace("$functionParameter", "alert");
System.out.println(jsFunction);
Più semplicemente, possiamo utilizzare il nuovo metodo
formatted della classe String
introdotto con Java 13, nel seguente modo:
String jsFunction = """
                    function dynamicFunction() {
                    \t%s(msg);
                    }""".formatted("alert");
System.out.println(jsFunction);
Possiamo notare come il metodo formatted abbia la stessa funzionalità sui
text block che ha il metodo format sugli String literal.
Infatti, il codice precedente è equivalente al seguente snippet:
String jsFunction = String.format("""
                                  function dynamicFunction() {
                                  \t%s(msg);
                                  }""","alert");
System.out.println(jsFunction);
indent,
stripIndent e
translateEscapes. Essi sono descritti brevemente nel
paragrafo F.4.3.5 dell'appendice F del mio ultimo libro "Il nuovo Java""". Tutte le
appendici (compresa l'appendice F) sono scaricabili gratuitamente in formato PDF nella
sezione download su https://www.nuovojava.it.
Conclusioni
I text block permettono di creare stringhe multilinea formattate, e questo ci permetterà di riportare facilmente codice formattato di altri linguaggi all'interno di codice Java. Dopo essere stati introdotti come feature preview nella versione 13, i text block sono ufficialmente stati promossi a caratteristica standard di Java nella versione 15. Le regole che governano i text block però non sono affatto scontate, e l'impatto sulle versioni precedenti è notevole per sintassi, nuovi caratteri di escape e nuovi metodi. Tuttavia, una volta capiti alcuni concetti, il loro utilizzo è semplice e particolarmente utile. Basti pensare all'utilizzo che ne faremo utilizzando con linguaggi come SQL, JPQL, JavaScript, JSON, XML, HTML, CSS etc.